读 Anthropic 招股书:两个 Loop 如何推动 AI 进化
2026 年 10 月 26 日,Anthropic 提交 S-1 招股书。比起上市估值,我更关心它如何把模型放进真实工作流,以及真实使用怎样反过来影响产品和研发。
这份招股书有三个值得关注的地方:企业工作负载增长后,产品如何分层;真实任务如何成为改进依据;AI 如何进入 AI 研发流程。
1. Anthropic 的营收与企业客户增长
| 指标 | 2024 年 | 2025 年 | 2026 上半年 |
|---|---|---|---|
| 营收 | 3.86 亿美元 | 45.85 亿美元 | 162.86 亿美元 |
| 经营亏损 | 29.80 亿美元 | 80.60 亿美元 | 6.93 亿美元 |
截至 2026 年 9 月,Anthropic 有 11,900 多家年贡献收入至少 10 万美元的客户,其中约 250 家达到千万美元级别。公司披露的 NRR 约为 900%,按其可比客户群体口径反映使用支出的快速扩张;它不是续约率,也不宜直接外推。
这些数字背后的变化更值得关注:模型调用开始承接大规模、持续性的企业工作负载,推理成本、容量规划、可靠性和系统集成也就成了产品设计的一部分。单看模型效果,已经很难判断一套 AI 系统能不能进入生产环境。
2. 产品分层:模型、平台与应用各有职责
Anthropic 将产品分为 Models、Platform 和 Applications 三层:模型提供智能,平台供企业和开发者接入、构建,应用则进入具体工作场景。
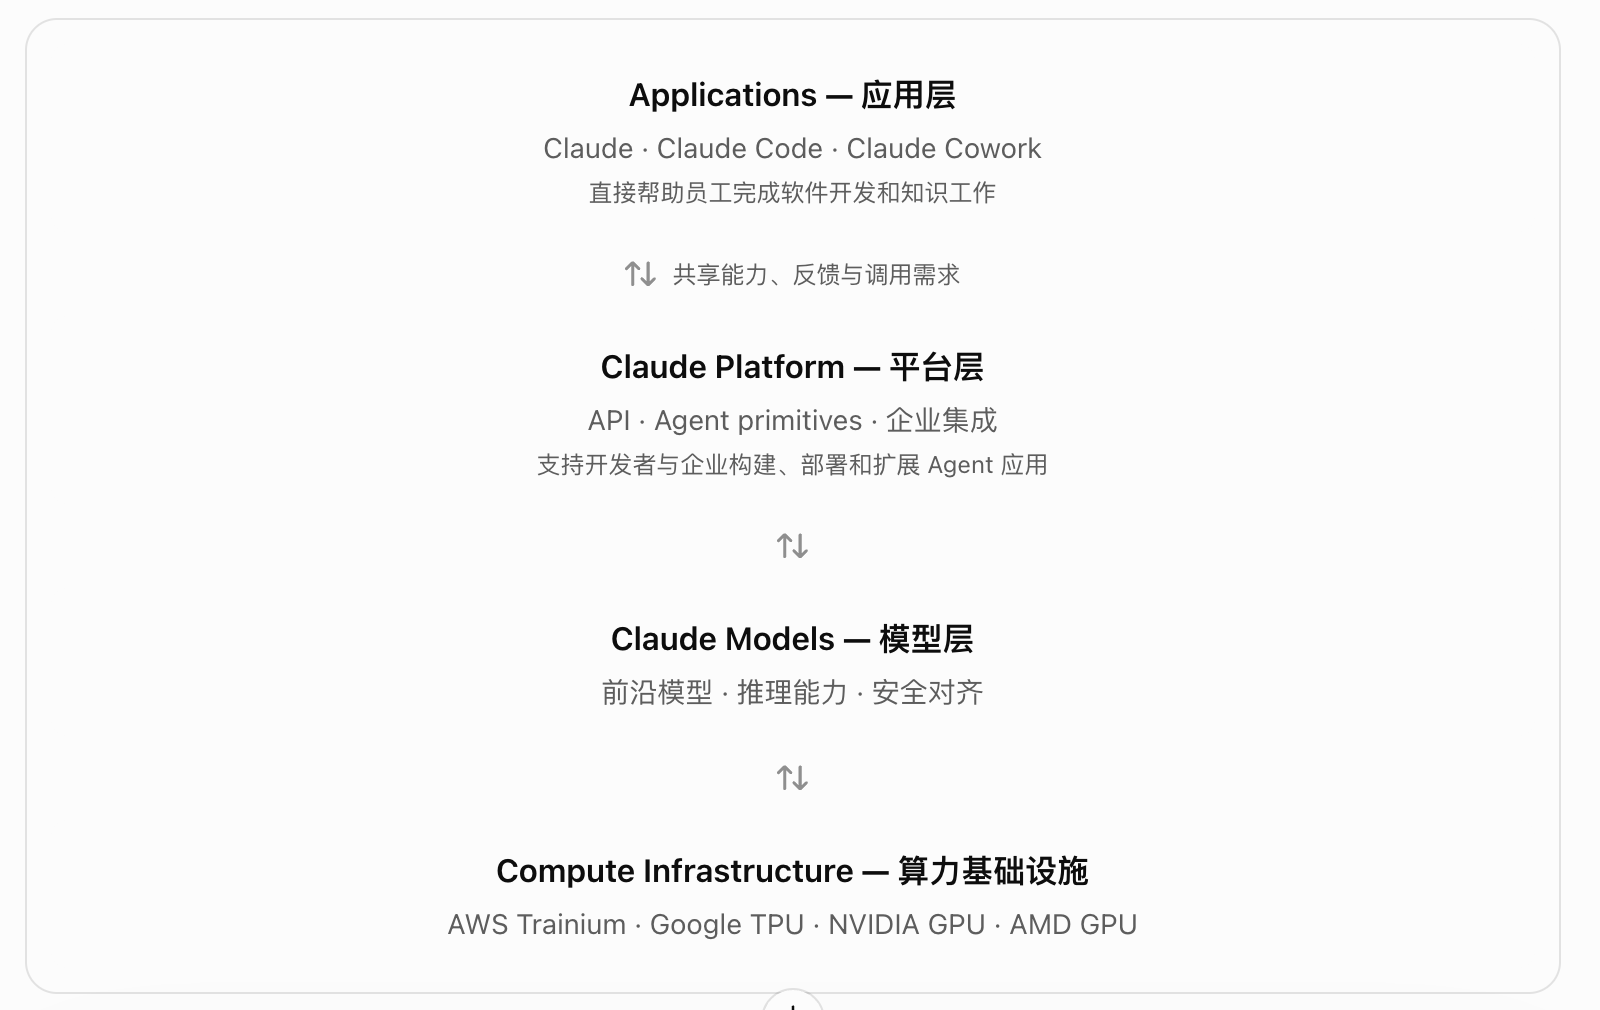
架构上的重点是边界与反馈:应用检验能力在真实任务中的表现,平台承接企业集成,模型提供可复用的底层能力。三层要能协作,产品才有机会从单次问答走进日常工作流。
招股书还披露,在年贡献收入至少 10 万美元的客户中,2026 年第三季度超过一半同时使用 Claude Platform 和至少一种 Anthropic 自有应用;2025 年第四季度这一比例约为 30%。这说明企业既在构建自己的 AI 系统,也在直接使用 Anthropic 的应用。
3. 研发中的两个循环:使用反馈与 AI 辅助研发
Improvement Loop:把真实任务变成改进依据
真实部署会暴露 Benchmark 难以覆盖的问题:上下文不完整、工具调用失败、业务约束冲突,或任务执行到一半偏离目标。把这些问题整理成可复现样本,再通过评测验证修复是否有效,才构成真正的改进循环。
以 CodeReview Agent 为例,可以把流程做成:候选问题 → 证据验证 → 人工采纳或驳回 → 样本沉淀 → 回归评测。这里的关键不是多收集数据,而是保留足够上下文,知道 Agent 为什么报出问题、判断是否正确,以及修改后是否减少了误报或漏报。
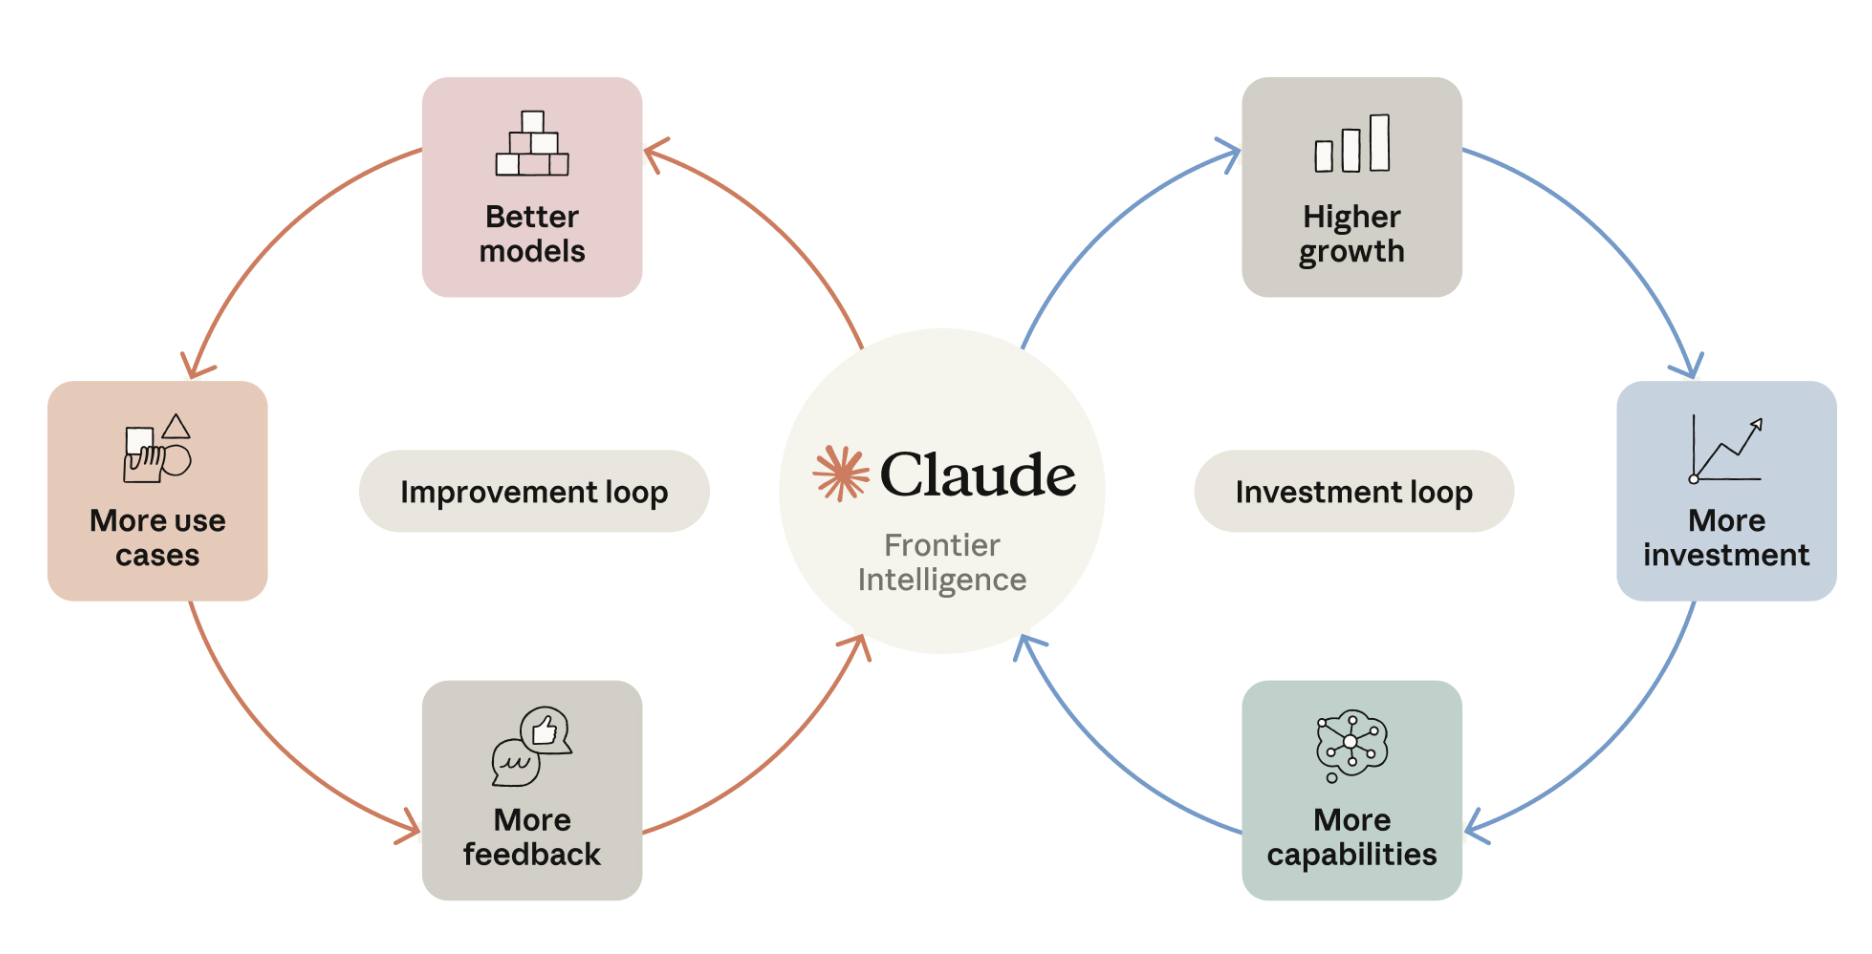
Closing the Loop:Claude 进入研发流程
Anthropic 披露,Claude 已参与研发实验、训练数据处理、代码编写与审查、模型评测和安全审计,也协助寻找训练与推理效率的优化方法。可以把它理解为:当前模型辅助研发,研发效率提升后产出新一代模型,新模型再参与后续研发。
这对研发架构的启发是,AI 可以参与的不只是写代码,还包括实验、评测和分析。但模型输出仍要经过人的判断和独立验证。Claude 参与下一代研发是招股书披露的实践;这种递归机制能否持续带来更强的加速,还需要时间检验。
4. 编程范式的变化:从逐步指挥到目标与约束
Agent 编程工具带来的变化,不只是代码生成更快,而是开发者开始把一段工作交给系统执行:说明目标、提供上下文和权限边界,再检查改动与验证结果。工具因此需要能读取项目、运行命令、观察执行结果,并在失败时修正。
工程实践的重心也随之变化:除了代码本身,还要设计任务边界、执行权限和结果验证。比起统计生成了多少代码,更实际的问题是修改是否通过测试、有没有引入回归,以及开发者是否能理解和接手最终结果。