Navi-Agent 的 Terminal-Bench 2.1 评测
去年 9 月,受 Codex 启发,我开始尝试写第一个 Coding Agent 原型,主要验证 ReAct 循环和 session 管理。后来,OpenClaw 的流行、Hermes 展现出的自我改进机制,以及 Coding Agent 在不同任务中的泛化能力,都让我很想进一步理解它们是怎么工作的。到了 2026 年 5 月,我逐步将这些想法做出来、跑起来,于是开始构建第二个属于自己的个人助理/Coding Agent —— Navi-Agent。
这件事基本是在回家后的晚上和周末一点点完成的,前后持续了几个月。国庆期间,我用 Navi-Agent 跑了一轮 Terminal-Bench 2.1,通过了 67 个任务,整体通过率为 75.3%,这算是一个说得过去的阶段性结果。这轮评测也更让我意识到,代码写出来只是第一步,Agent 的最终交付物能否通过验收才是最重要的。
所以,这篇文章主要记录这次评测到底跑了什么、哪些任务通过了、失败发生在哪里,以及我从这些失败中看到的工程问题。
Navi-Agent 架构
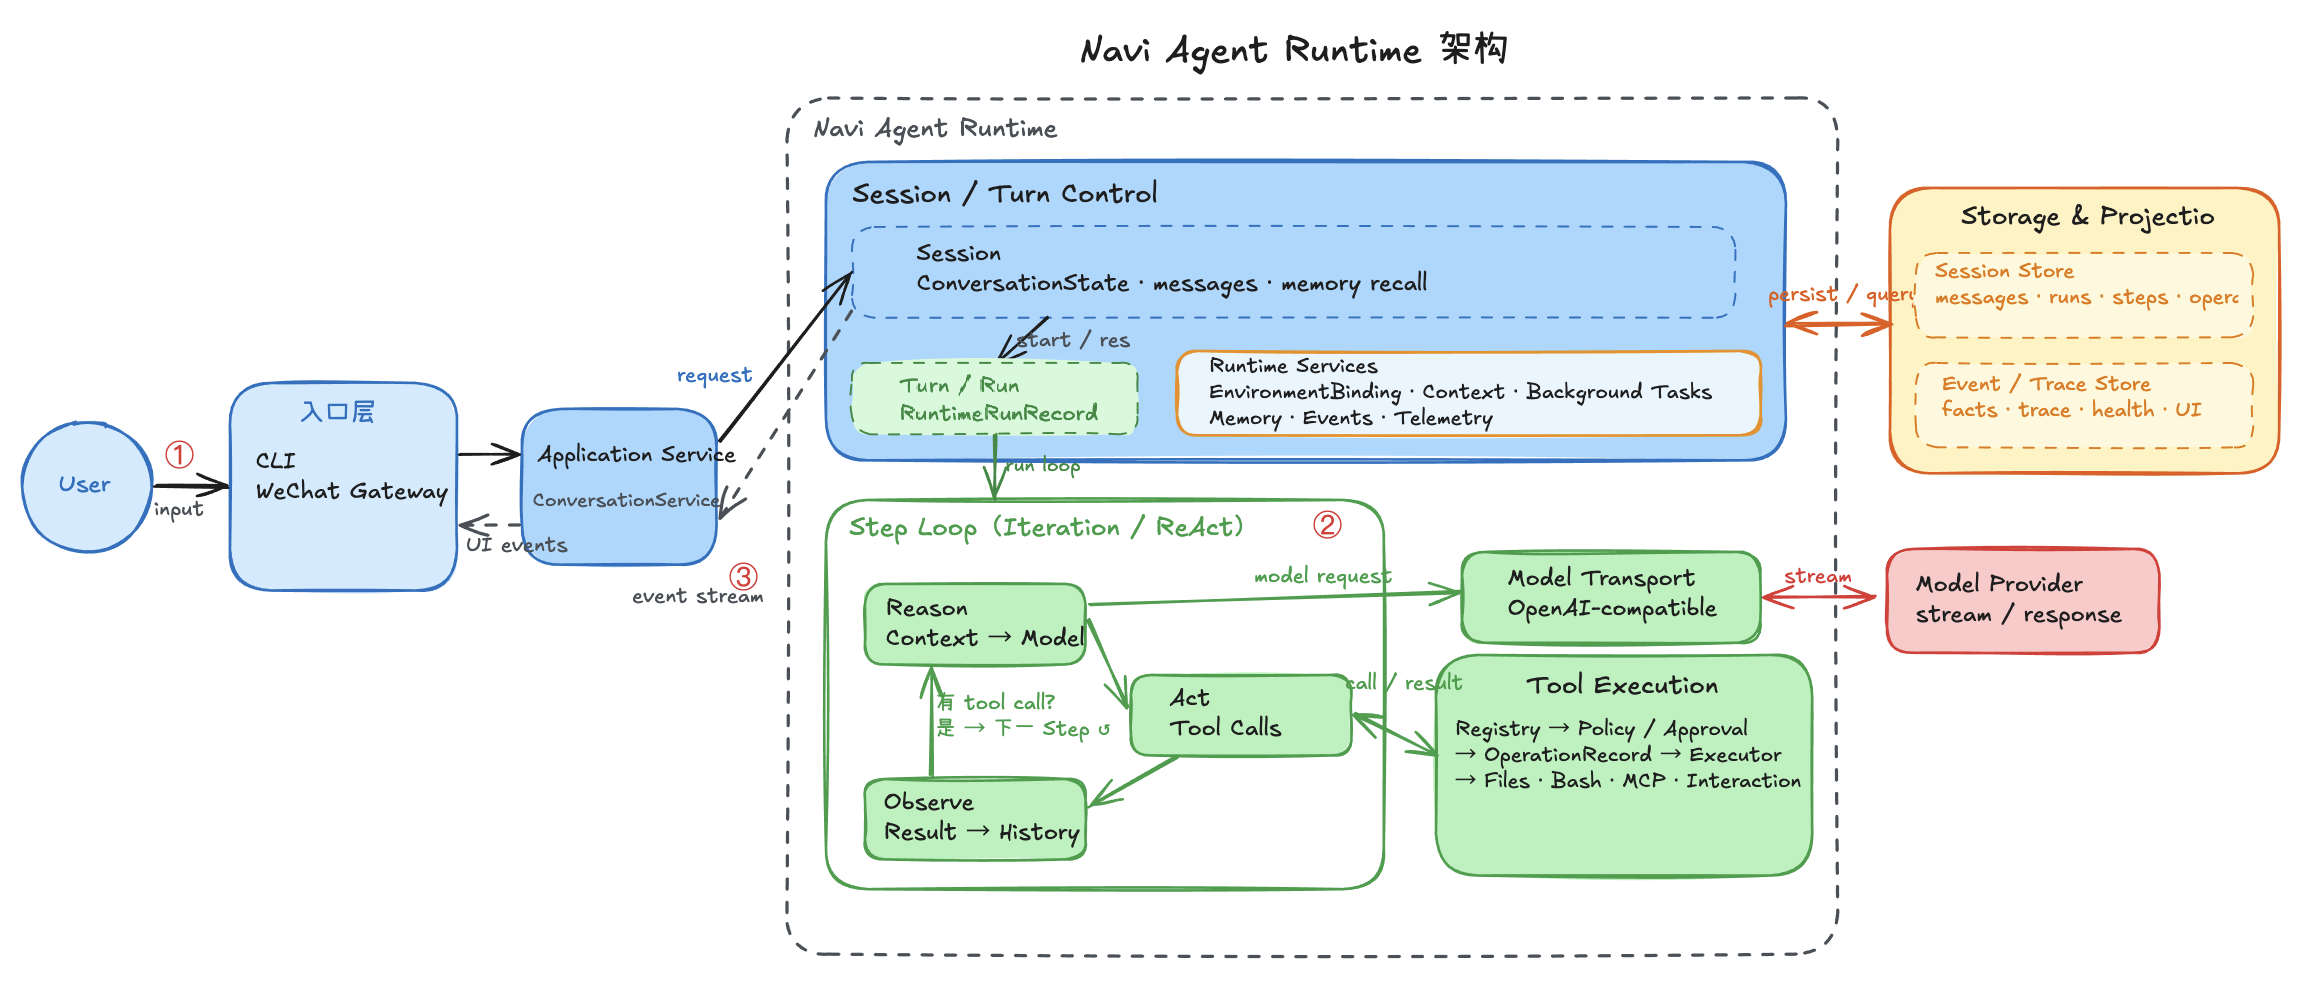
Navi-Agent 的基本流程和大多数 Coding Agent 类似,但我更关注任务执行过程是否可观察、是否能够稳定收尾,以及最终交付物能否被独立验证。它接收一个任务,由模型决定下一步行动,调用工具执行命令或修改文件,再根据执行结果决定继续还是结束。
我没有增加 planner、critic 或专用 Agent,而是先把 Runtime 本身做稳定。Runtime 负责管理 session、工具调用、迭代过程和结束条件;工具只负责执行命令、读写文件等具体操作,不负责判断任务是否完成;trace 负责记录过程,便于调试和评测;外部验证器负责判断最终交付物是否真的正确。
这些取舍不是凭空决定的。Pi Agent 让我看到简洁 Agent 循环的价值,Codex 让我更重视 Session/Turn/Step 和执行环境的边界,Hermes 则让我开始思考 Agent 如何通过记忆和 Skill 积累能力。Navi-Agent 并不是这些理念的简单拼接,而是根据自己的判断做了一些取舍:先把任务执行、可观察性和评测闭环做好,再考虑更复杂的自我改进能力。
结论先行
此次评测覆盖 Terminal-Bench 2.1 的全部 89 个任务。任务分批在 Modal Sandbox 中执行,模型为 deepseek-flash,并由 Harbor 验证器独立判定交付物是否正确。
| 指标 | 结果 | 含义 |
|---|---|---|
| Harbor 验证器通过 | 67 / 89(75.3%) | 任务交付物满足独立验证 |
| Harbor 验证器失败 | 22 / 89(24.7%) | 工作区或行为未满足验收要求 |
| Runtime 完成 | 86 / 89(96.6%) | Navi 返回非空最终响应 |
| Runtime 未完成 | 3 / 89(3.4%) | session 有运行记录,但未形成有效最终答复 |
1
2
Harbor 验证器      67/89  ███████████████░░░░░ 75.3%
Runtime 完成       86/89  ███████████████████░ 96.6%
75.3% 的评测结果和 Runtime 96.6% 之间的差距,说明 Agent 能正常结束,并不等于任务已经完成。
评测设计
| 维度 | 设置 |
|---|---|
| 数据集 | Terminal-Bench 2.1,89 个任务 |
| Agent | Navi-Agent |
| 模型 | deepseek-flash |
| 沙箱 | Modal Sandbox |
| 运行器 | Inspect AI + inspect-harbor |
| 正确性 | Harbor 验证器 |
| 迭代预算 | 50;到达上限时允许无工具总结兜底 |
评测时,Navi-Agent 的工具调用直接进入每个任务独立的 Sandbox;文件、网络、编译结果和测试输出均留在该 Sandbox。Harbor 验证器在 Agent 停止后检查最终工作区。
任务分批并发运行,每批最多 4 个 Modal Sandbox。
| Harbor 失败的运行时形态 | 数量 | 解读 |
|---|---|---|
iteration_limit_summary | 10 | 模型持续工具调用到预算上限;总结不是完成证据 |
| 无有效最终响应 | 3 | runtime 状态或输出交接不完整 |
| 正常最终响应,但验证器失败 | 9 | 自我判断或局部测试不足以代表验收通过 |
这也是 Navi-Agent 迭代 TaskSpec、验收条件、验证收敛、completion_reason 的原因:它们不负责替模型“判断正确”,而是把“模型声明”“运行时收尾”“外部证据”拆开记录。
本次评测按 Terminal-Bench 2.1 的官方分类汇总结果,共 16 个类别。
| 官方分类 | 任务数 | 通过数 | 通过率 |
|---|---|---|---|
| data-processing | 4 | 4 | 100.0% |
| data-querying | 1 | 1 | 100.0% |
| data-science | 8 | 7 | 87.5% |
| debugging | 5 | 3 | 60.0% |
| file-operations | 5 | 2 | 40.0% |
| games | 1 | 1 | 100.0% |
| machine-learning | 3 | 2 | 66.7% |
| mathematics | 4 | 4 | 100.0% |
| model-training | 4 | 2 | 50.0% |
| optimization | 1 | 1 | 100.0% |
| personal-assistant | 1 | 1 | 100.0% |
| scientific-computing | 8 | 6 | 75.0% |
| security | 8 | 7 | 87.5% |
| software-engineering | 26 | 19 | 73.1% |
| system-administration | 9 | 6 | 66.7% |
| video-processing | 1 | 1 | 100.0% |
从任务数相对较多的类别看,security 通过 7/8、data-science 通过 7/8、software-engineering 通过 19/26;file-operations 通过 2/5,是当前通过率最低的类别。按难度看,easy 为 4/4、medium 为 43/55(78.2%)、hard 为 20/30(66.7%)。
运行效率、Token 与成本
这里的统计范围是全部 89 条任务的 Navi trace。duration 是 Agent runtime 从开始到最终响应的时长。
P90 比平均数更能揭示执行框架的长尾:10% 的任务至少消耗 51 次迭代、14 分 47 秒或 2.47M input token。
每任务点图视图
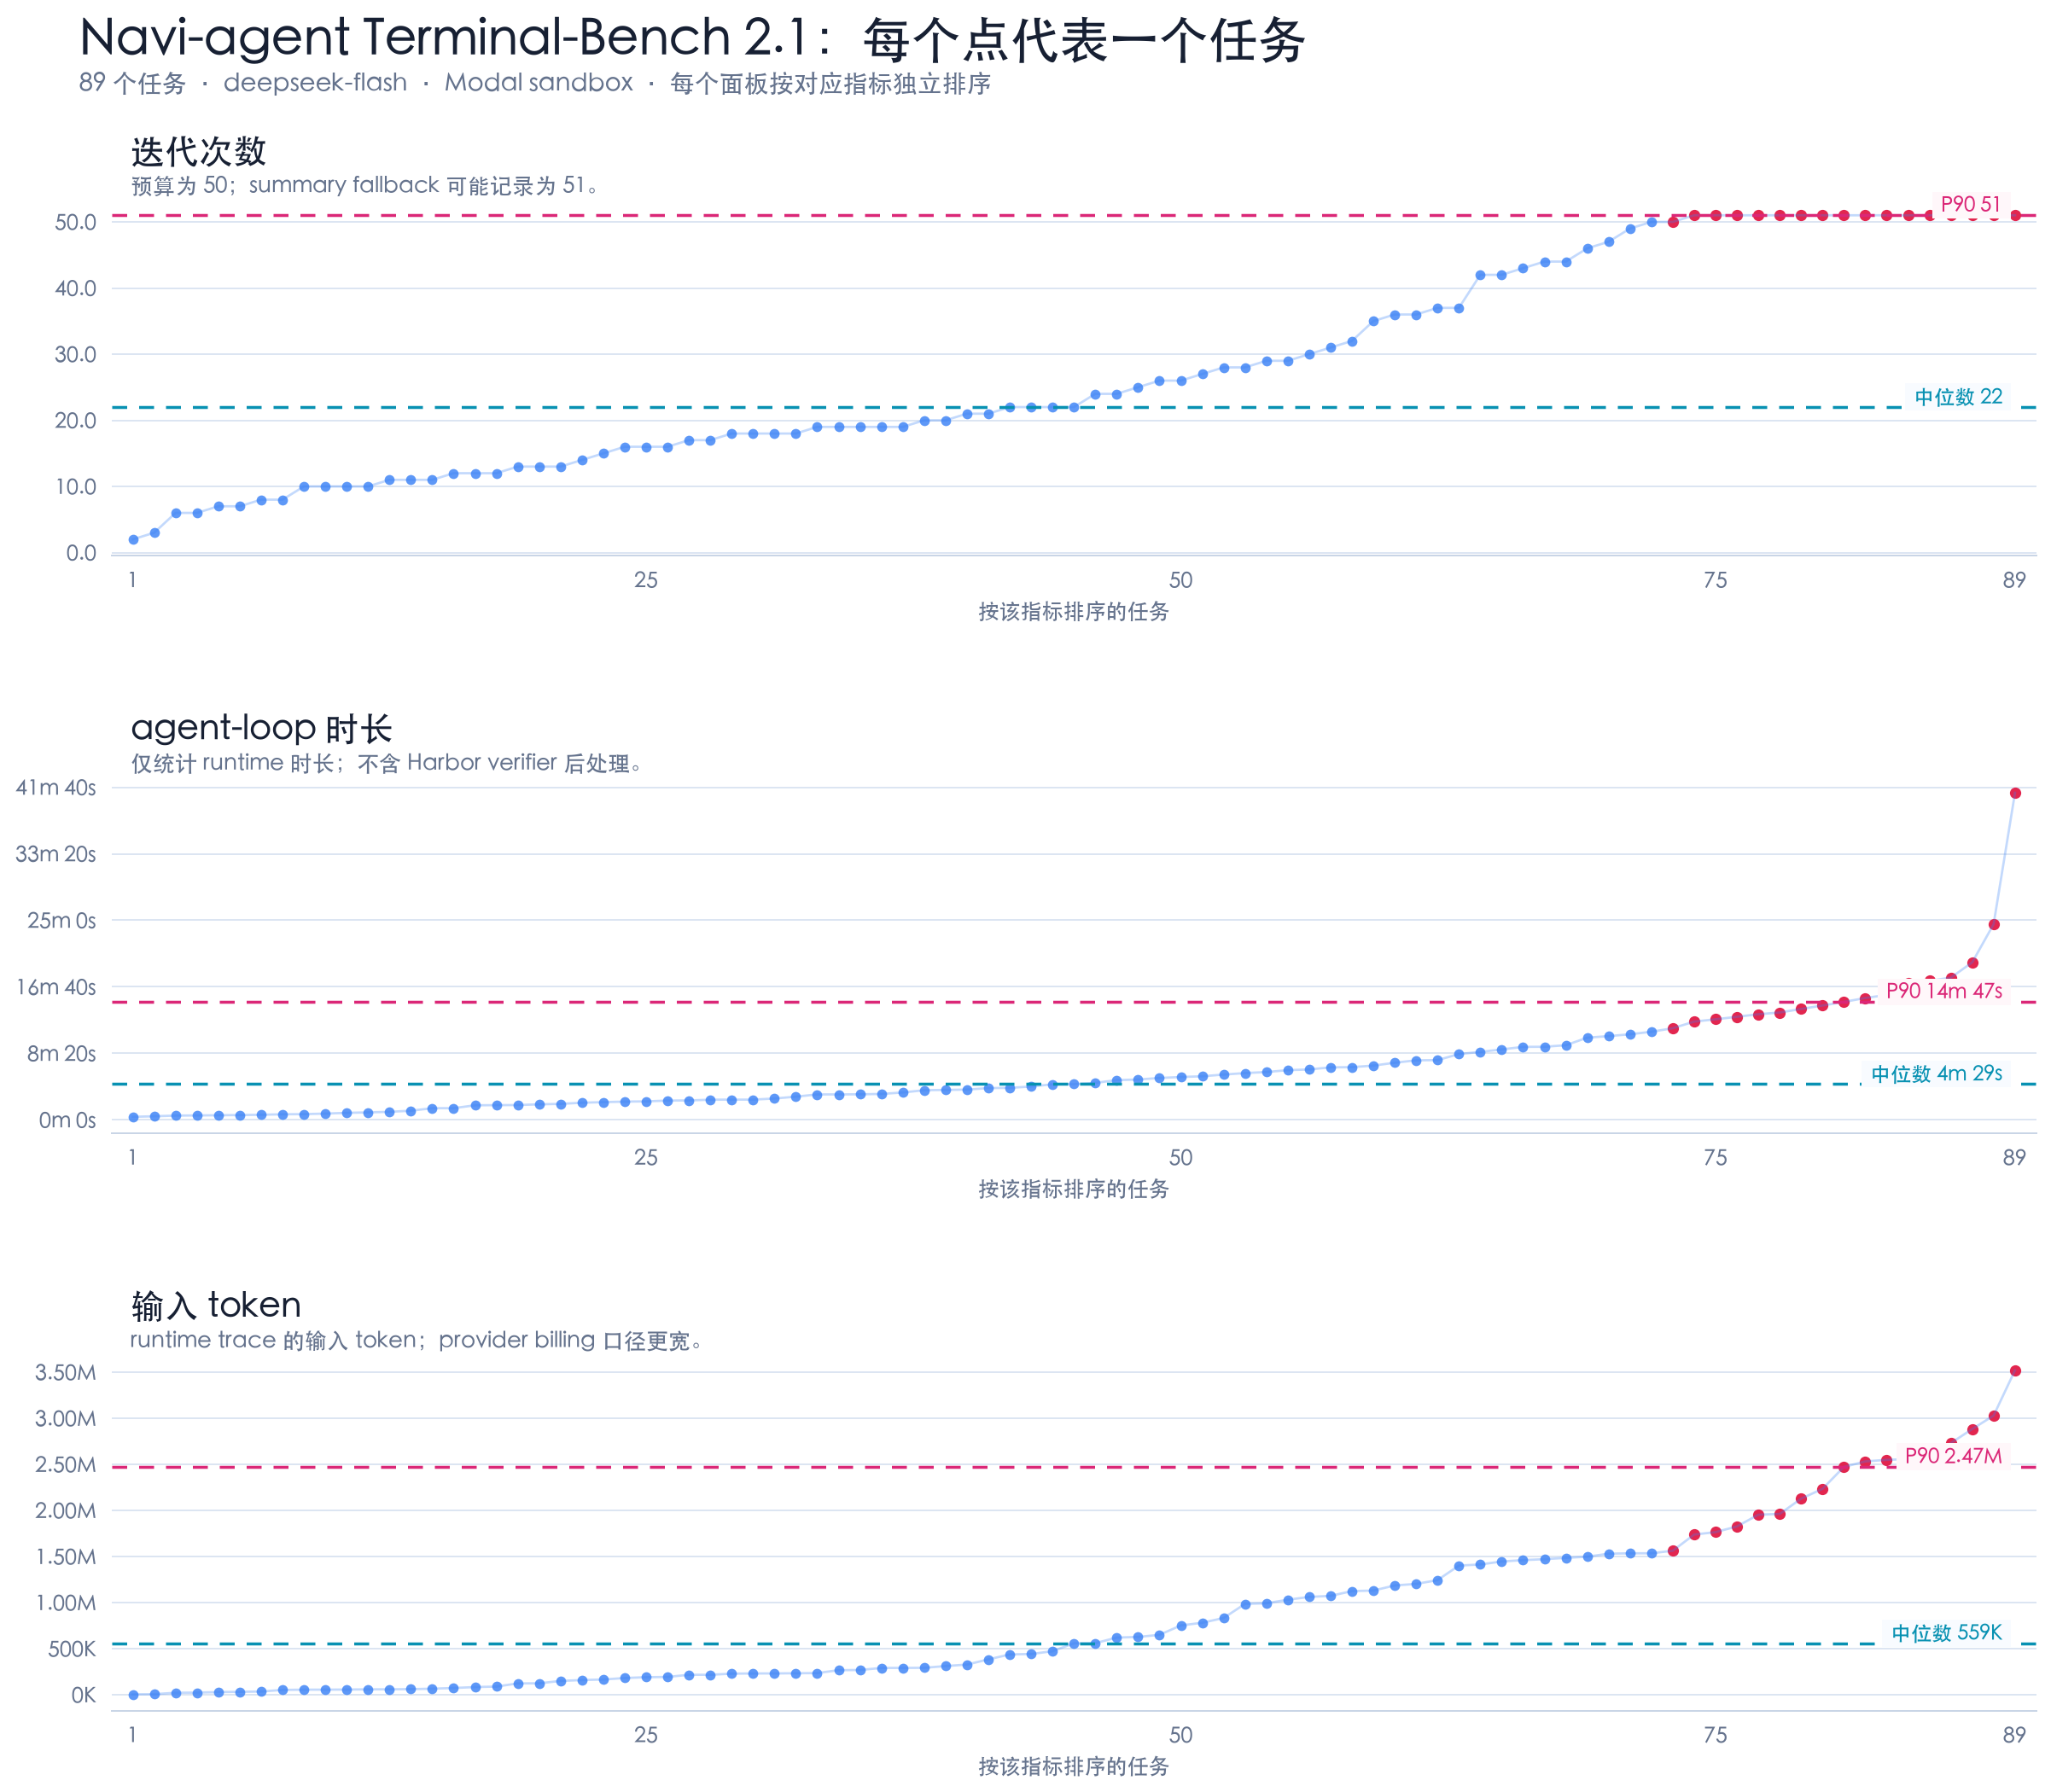
这里每个点代表一个任务,并按该指标自身的数值排序。排名 70–80 之后,迭代次数、时间和 input token 都出现明显陡升,说明少数复杂任务拉长了整体尾部。
从每任务分布看,中位数为 22 次迭代、4 分 29 秒 agent-loop 时长和 559K input token;P90 分别升至 51 次、14 分 47 秒和 2.47M。Output token 的中位数为 28.2K,P90 为 97.0K。
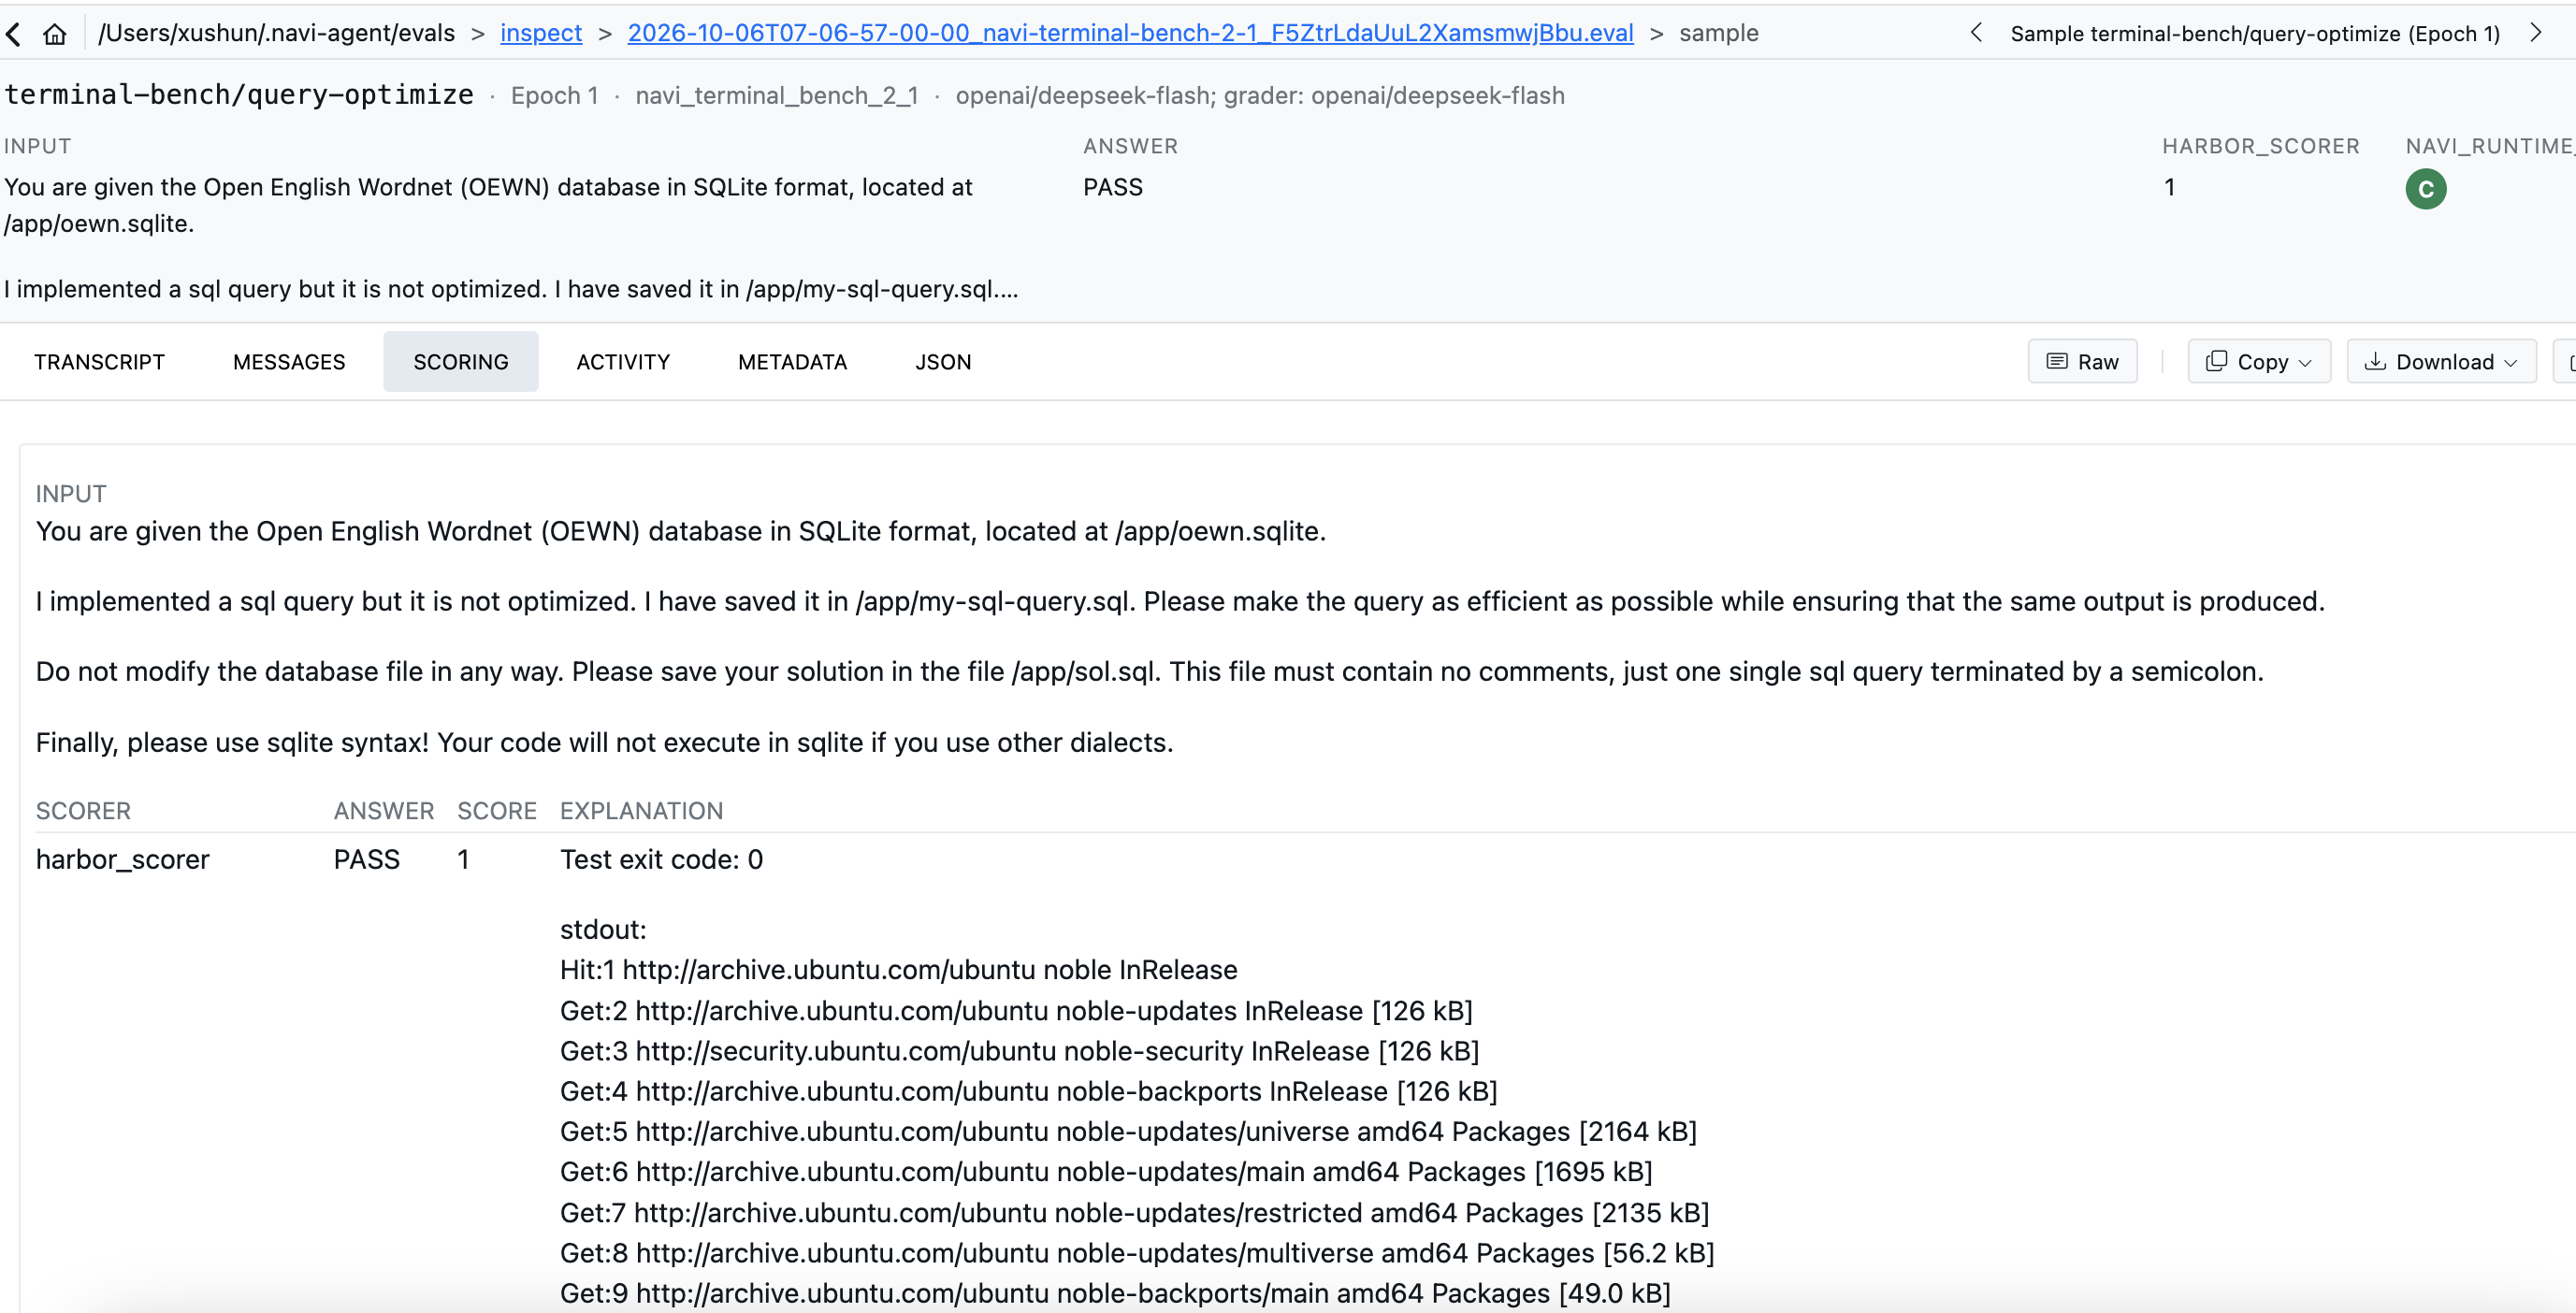
下面这张 Inspect 样例截图展示了单个任务的运行结果和验证器判定。
本轮模型和 Modal 费用。
失败案例分析和处理
1. 代码基本完成,但交付物没有放到正确位置
winning-avg-corewars 找到了候选 warrior,却没有复制到验证器要求的位置;large-scale-text-editing 的 Vim macro 漏了 :wq。处理方式是把最终文件、路径和格式纳入验收条件,并在最后一次修改后重新检查。
2. 环境没有准备好,不能当成代码失败
polyglot-c-py 遇到 apt 锁,qemu-startup 遇到 Debian 仓库 404,导致依赖没有安装。处理方式是保留原始错误,区分环境失败和代码失败,并通过固定镜像、依赖版本和可重试初始化来改善环境;不在 Navi runtime 中加入 Terminal-Bench 特判。
3. 局部测试通过,但没有满足真实验收条件
build-cython-ext 的局部测试通过,但 Harbor 发现功能测试失败;filter-js-from-html 的 sanitizer 检查通过,也不能证明它能抵御真实 XSS。处理方式是提供明确的验收命令,并让测试证据绑定最近一次文件修改;发生新的文件修改后,旧证据自动失效。
4. 达到迭代上限,不代表任务成功
本轮有 10 个任务走了 iteration_limit_summary,包括 gcode-to-text、make-mips-interpreter 和 qemu-alpine-ssh。达到上限时,runtime 会给 Agent 一次无工具总结机会,但这只保证 session 有最终响应,不代表任务通过;compile-compcert 虽然走了同样的总结流程,最终仍通过了 Harbor。
这里需要说明评测口径:本轮全量评测使用了针对失败案例做过的 runtime 修复,但修复并不意味着所有任务都会通过。本文允许失败,按实际结果如实展示,并说明失败发生在哪一层。
这次主要做了四件事:
- 到达迭代上限时提供一次无工具总结,保证 session 有最终响应,但不标记为任务通过;
- 测试证据绑定最近一次文件修改,发生新的文件修改后必须重新验证;
- 分开记录 runtime 是否结束、是否有完成证据和结束原因,最终正确性仍以 Harbor 验证器为准;
- 用
TaskSpec明确任务目标、验收条件和约束,让 runtime、工具证据和验证器对齐。
所以,runtime 成功只表示会话正常结束,不代表任务已经完成。
结果说明
Terminal-Bench 的公开排行榜汇总了不同 Agent、模型、提示词、迭代预算和硬件设置,下面的榜单仅作参考。
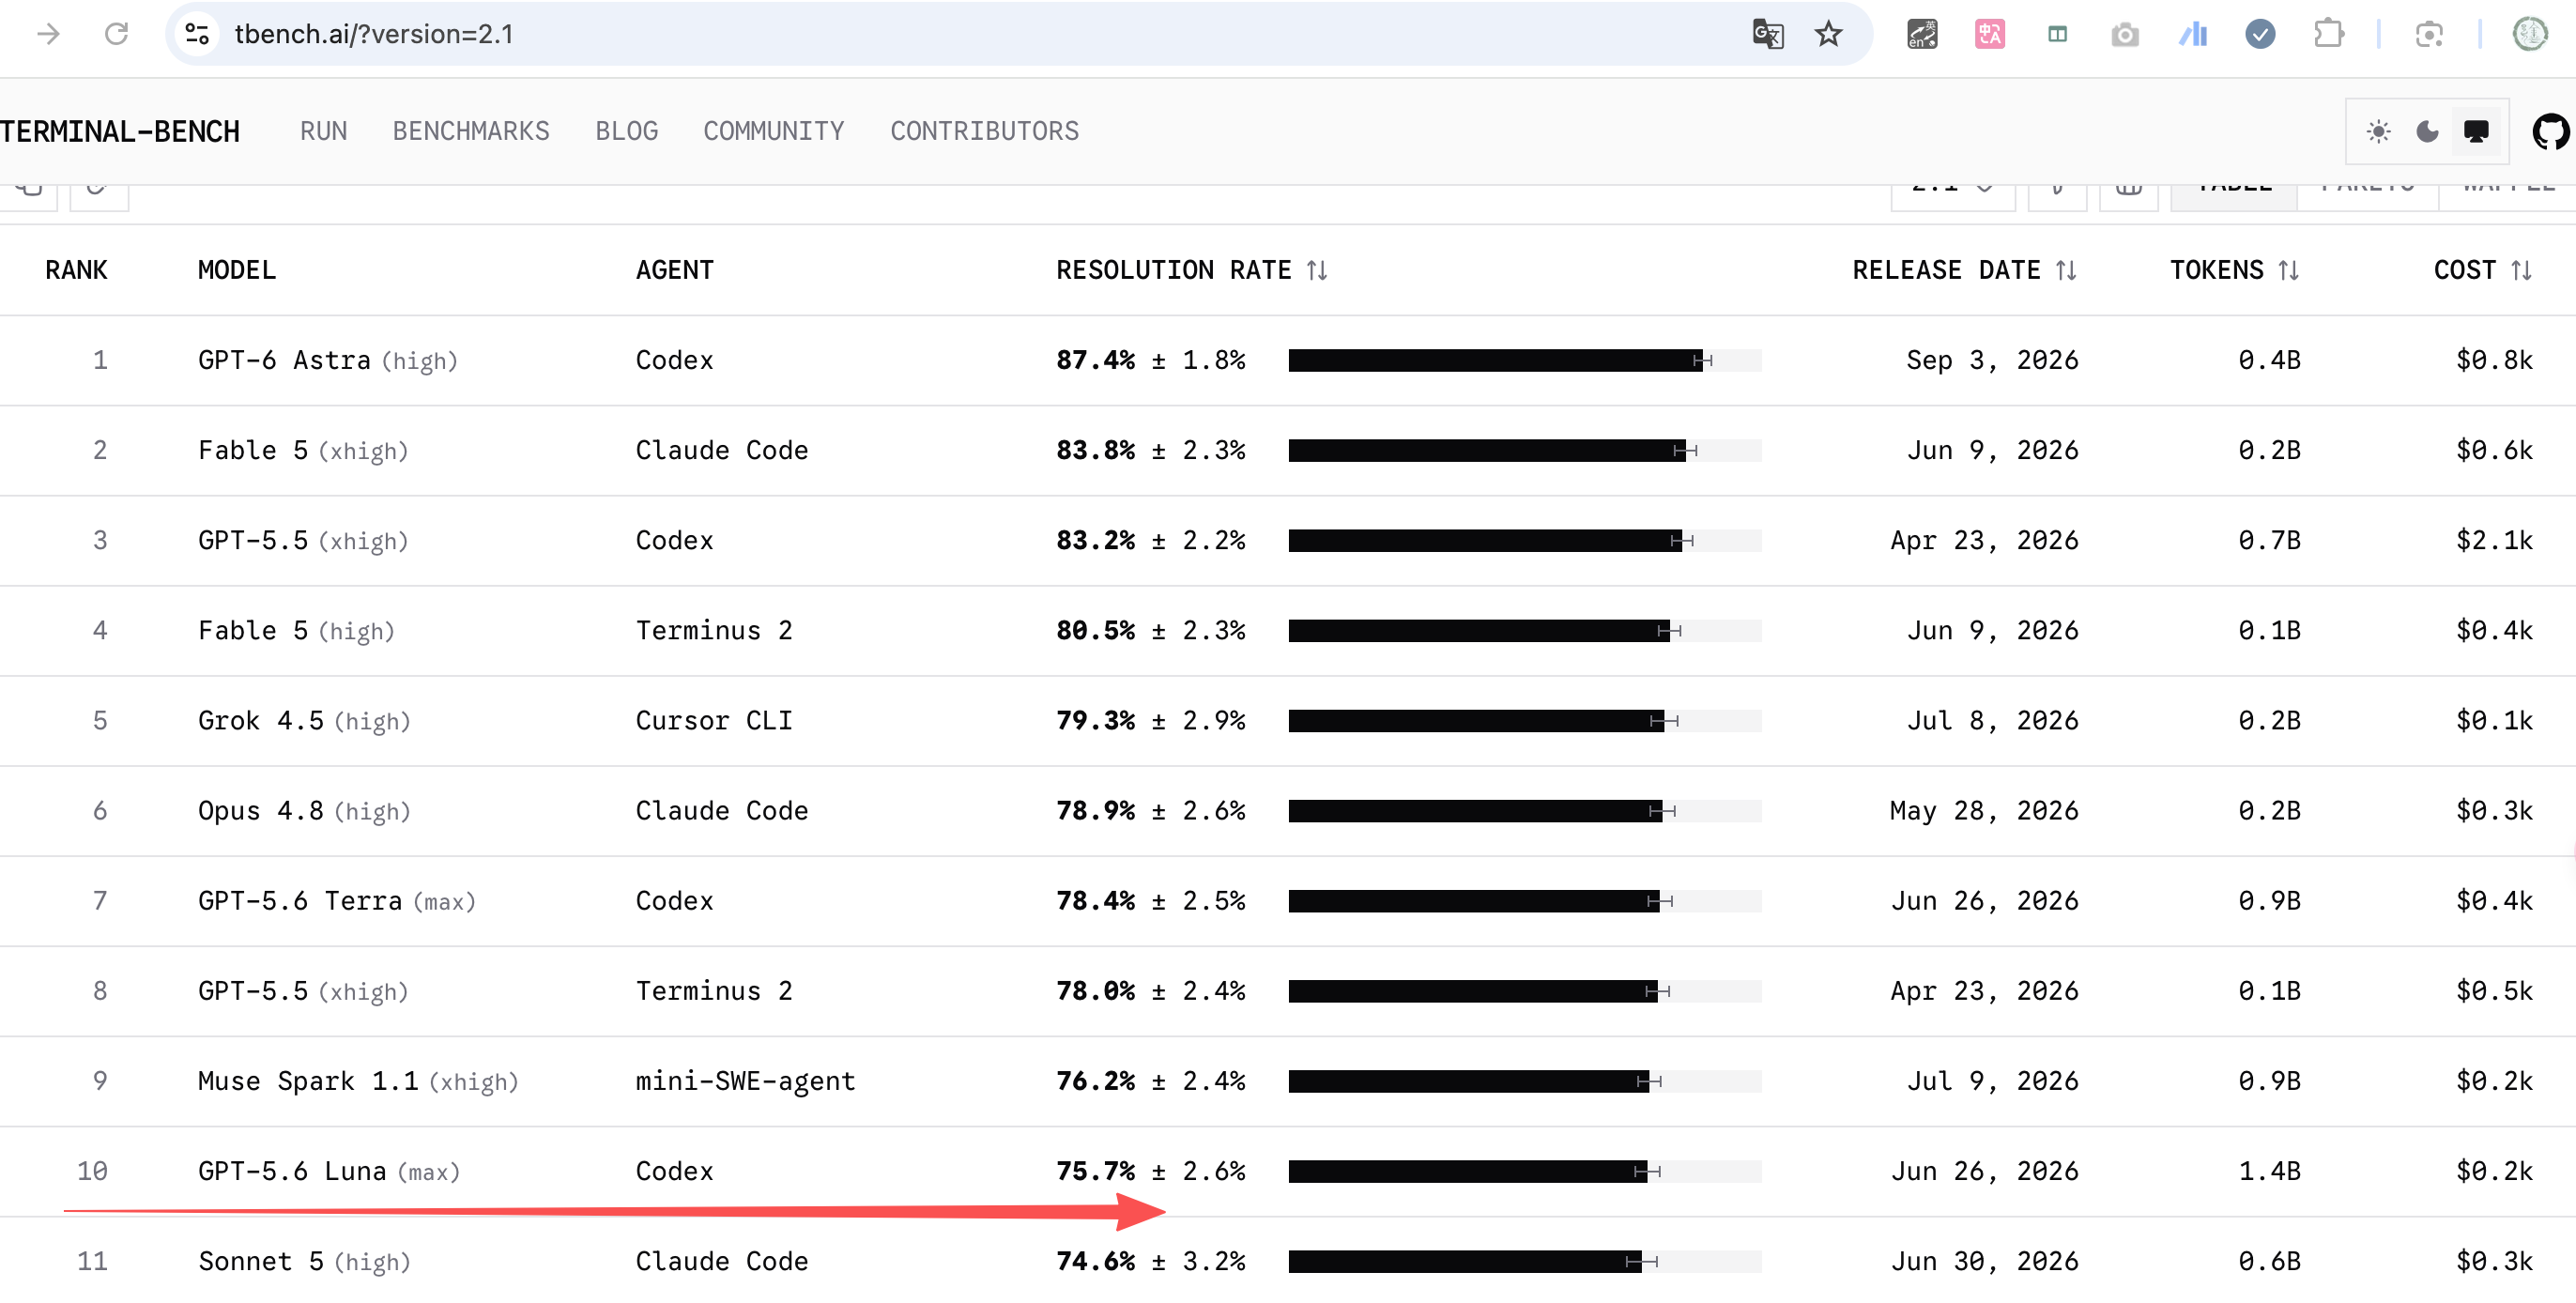
本次使用 Navi-Agent 和 deepseek-flash,在 Modal Sandbox 中运行 89 个任务,Harbor 验证器通过 67 个(75.3%)。Agent runtime 总时长为 9 小时 44 分 18 秒,共消耗 82.05M token;模型费用约为 ¥19.03,Modal Sandbox 费用为 $12.28。结果仅代表本次固定运行设置,不是官方排名。
这轮评测得到的几个结论:
- Agent 能正常结束,不等于任务已经完成,最后还是要看验收结果。
- 22 个失败的原因并不相同,有代码和推理问题,也有交付遗漏、环境依赖和迭代上限问题。
- 暂时不急着继续增加迭代次数,先把失败案例、验收条件和环境诊断做扎实。
最后,我们也在团队中实践 Loop Engineering:用评测持续改进单个 Agent 的能力,再让不同 Agent 协同起来,串联起完整的交付流程。
附录:相关链接
- 项目代码:Navi-Agent
- 费用说明:Modal pricing
- 评测基准:Terminal-Bench 2.1
- 论文与结果:Terminal-Bench 论文与基准结果
- 日志查看:Inspect AI 评测日志