从 Agent 开发走向 LLM 训练:1.69 元跑通 nanoGPT Shakespeare
我正在构建 Navi Agent,一个主要受 Hermes 和 Codex 启发、当前聚焦评测与 Runtime 的轻量 Agent。过去我主要站在 Agent 工程一侧使用模型:设计提示词、调用工具、维护上下文、处理记忆与工作流。但当系统效果不稳定时,很多问题最终都会回到模型本身:token 是怎样形成的,模型为什么续写而不是“思考”,上下文为什么会丢失,微调究竟改变了什么?
为了建立更扎实的直觉,我决定从随机初始化开始训练一个小语言模型。第一站不是中文对话模型,而是 nanoGPT 的 Shakespeare 字符级模型。它规模很小,却包含了语言模型训练最核心的闭环:
1
2
文本 → token → batch → Transformer → logits
→ cross-entropy → backward → AdamW → checkpoint → 自回归生成
这篇文章记录第一次实验,包括云资源、数据处理、训练曲线、过拟合、checkpoint 恢复,以及这些经验如何反过来帮助 Agent 开发。
1. 实验目标
这次不追求“训练一个有用的 ChatGPT”,而是验证五件事:
- 模型权重从随机值开始训练,而不是微调现成模型。
- 能看到 train loss 和 validation loss 的变化。
- 能保存 checkpoint,并重新加载生成文本。
- 能从 checkpoint 恢复 optimizer 并继续训练。
- 能记录完整环境、数据哈希、代码版本、耗时和费用。
上游使用 karpathy/nanoGPT,固定 commit:
1
3adf61e154c3fe3fca428ad6bc3818b27a3b8291
2. 云资源与实际费用
最终使用 AutoDL 按量实例:
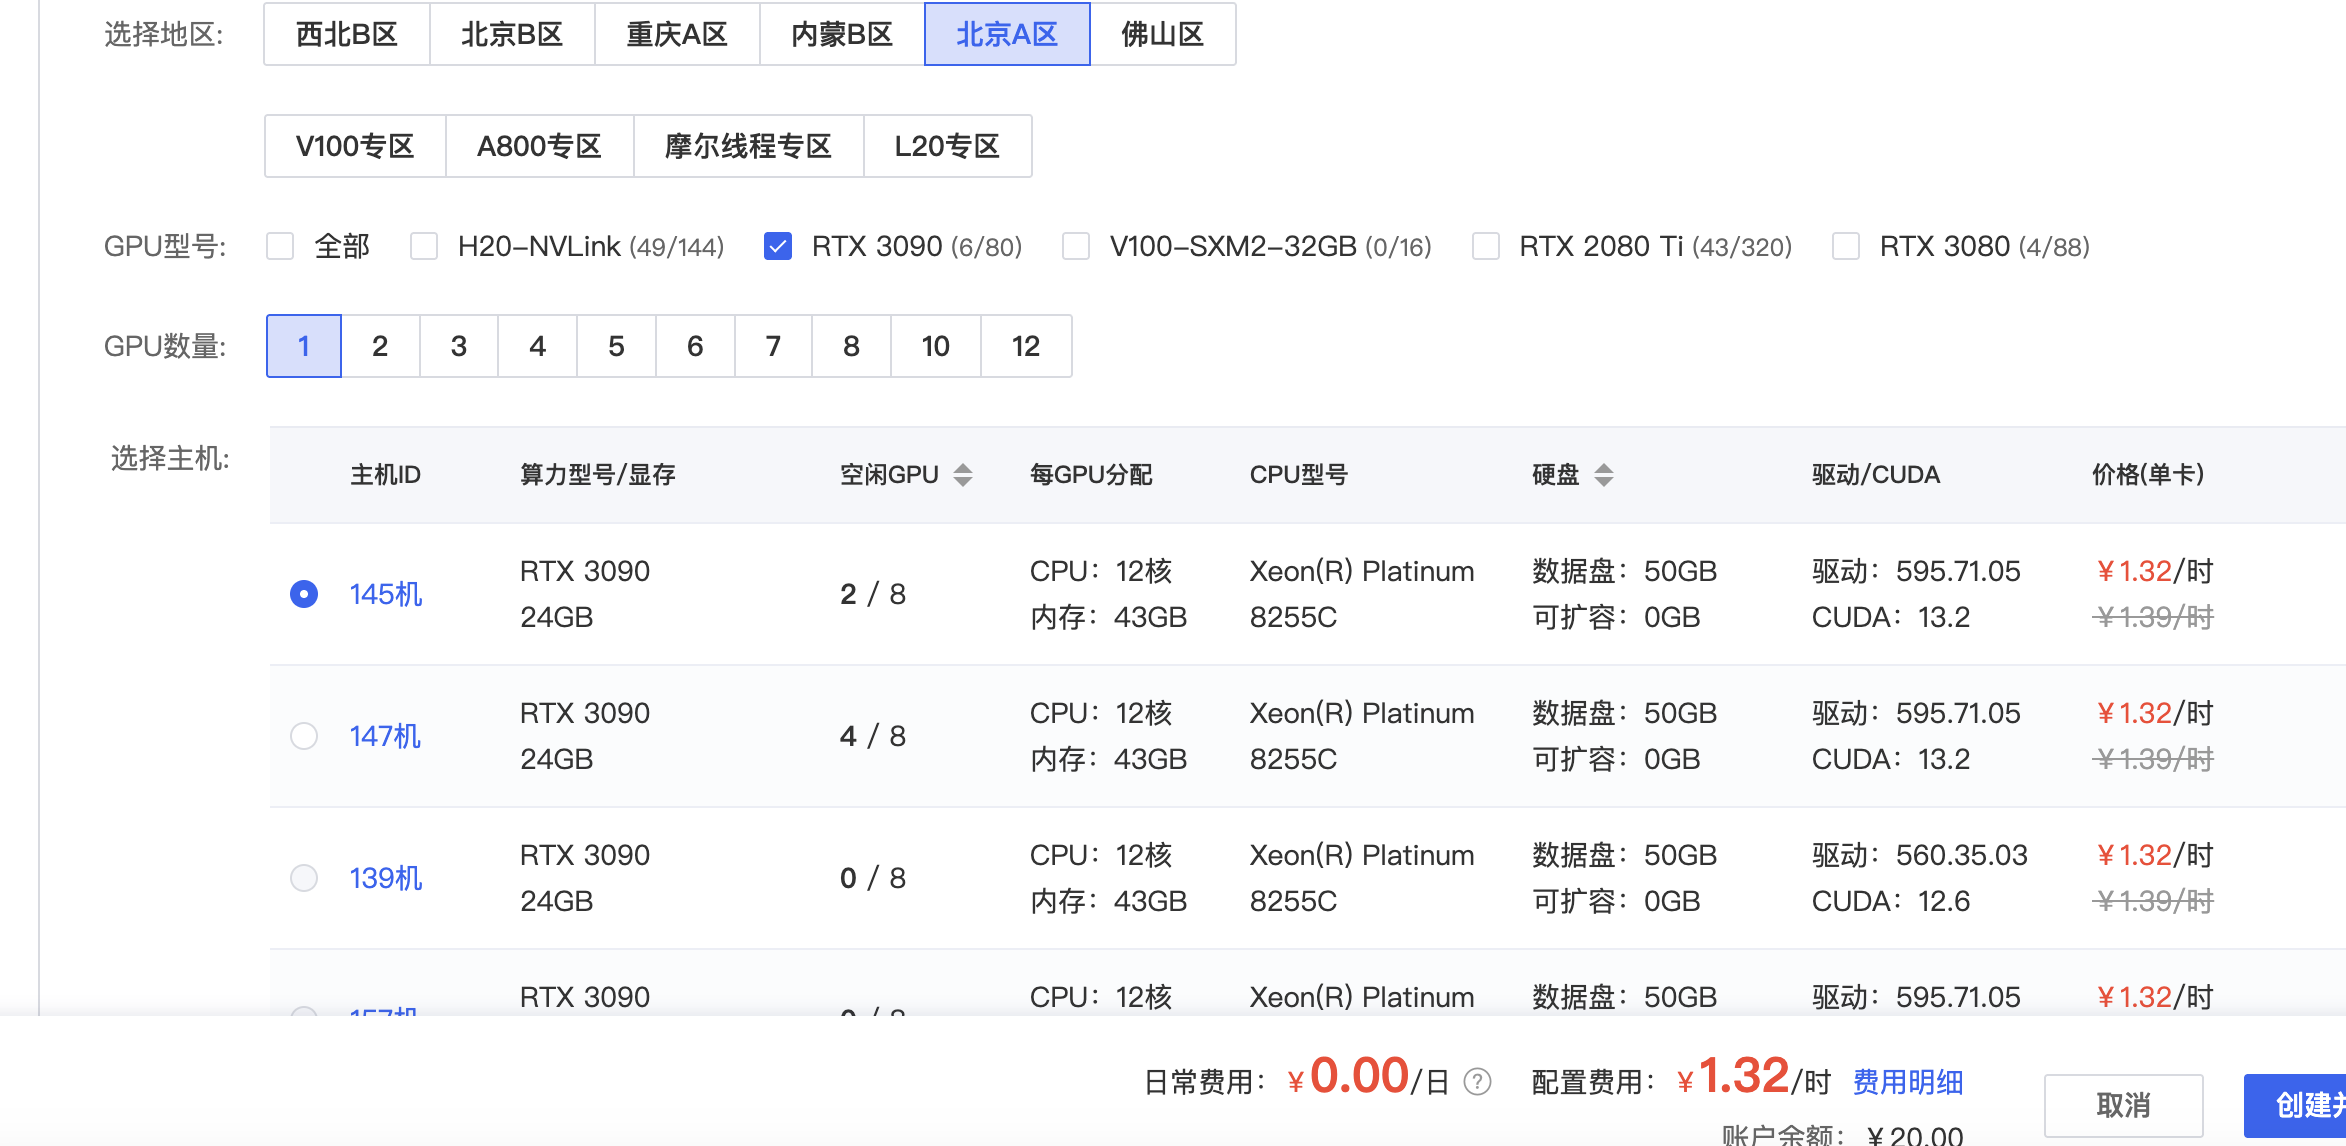
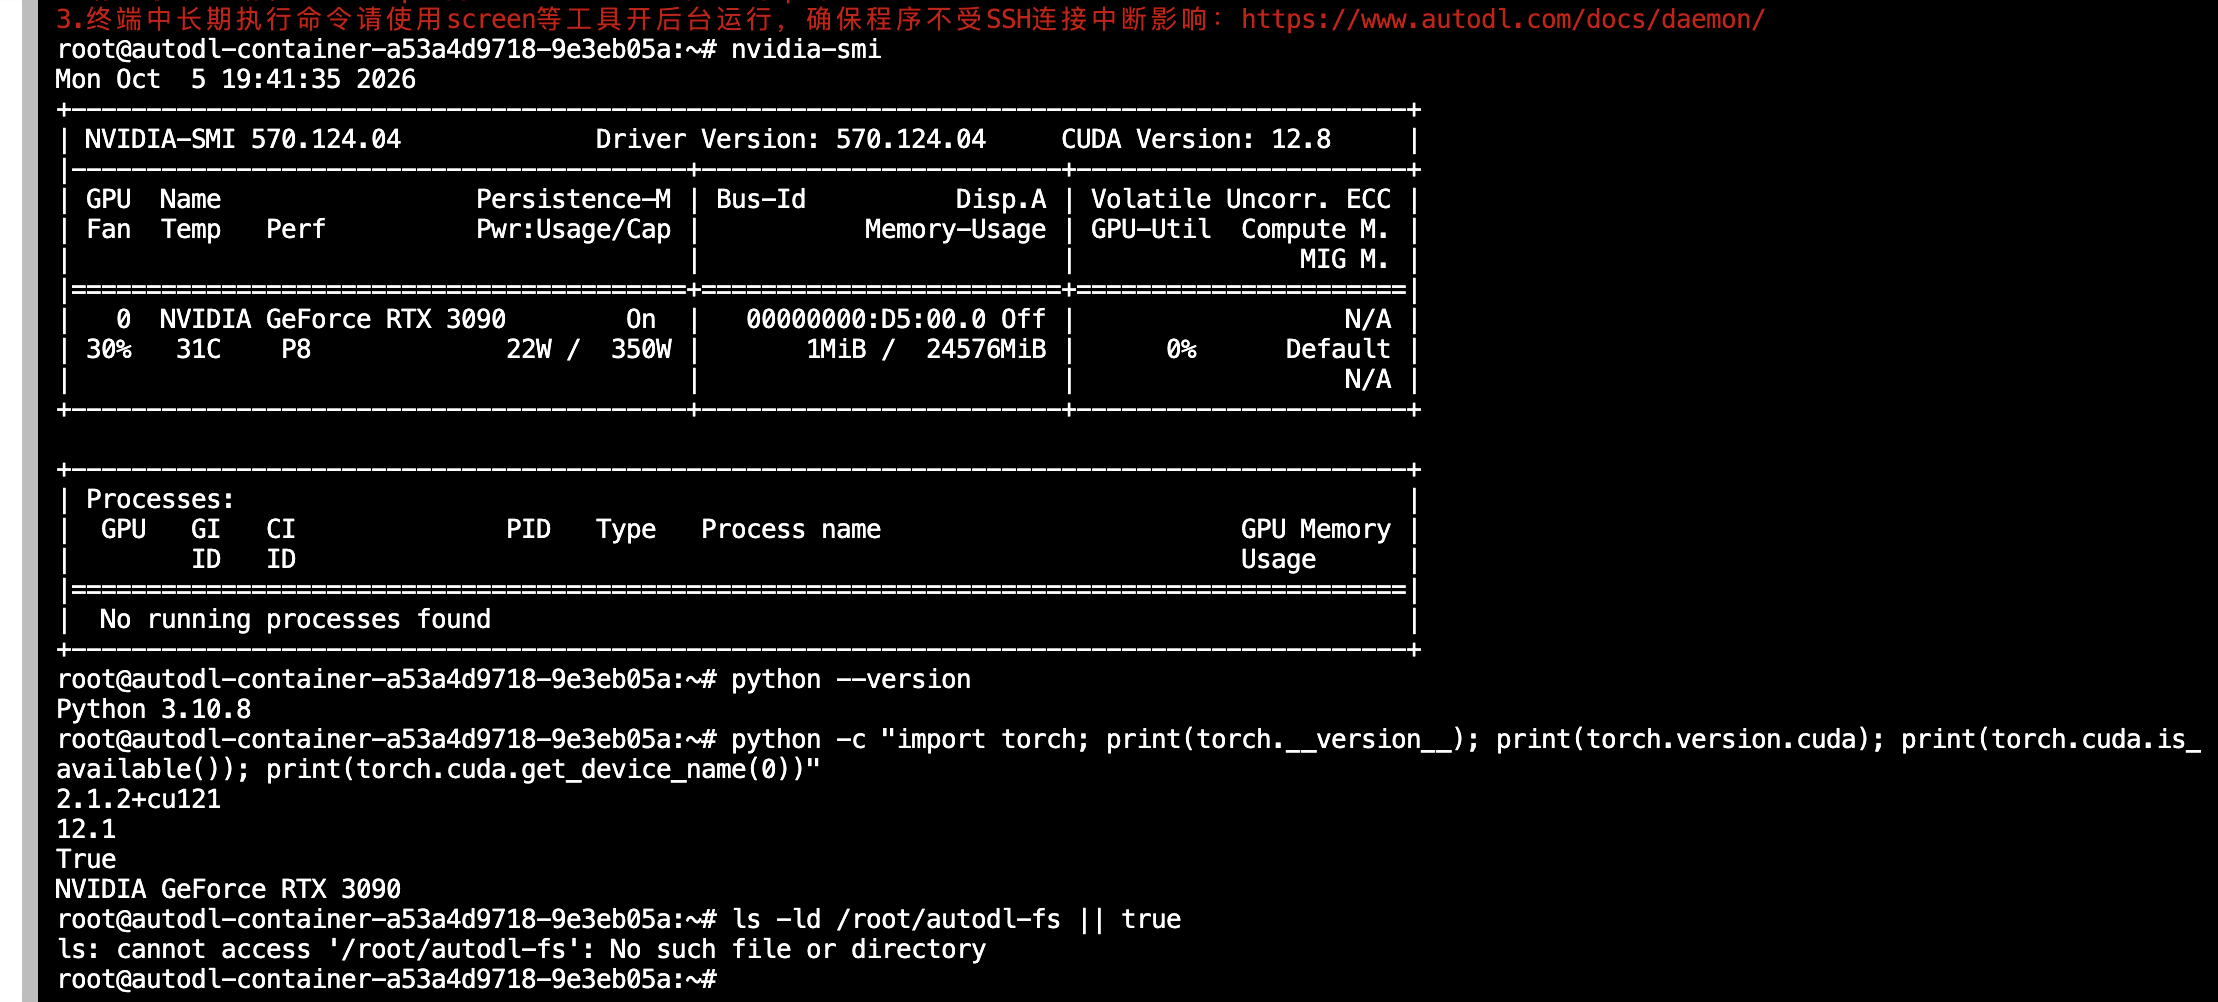
| 项目 | 配置 |
|---|---|
| GPU | 1×RTX 3090 24GB |
| CPU | 14 核 |
| 内存 | 90GB |
| 数据盘 | 50GB NVMe |
| Python | 3.10.8 |
| PyTorch | 2.1.2+cu121 |
| CUDA Runtime | 12.1 |
| cuDNN | 8.9.2 |
| 单价 | 1.32 元/小时 |
账单分两次扣费,共计 1.69 元,关机后余额为 18.31 元。纯训练耗时远低于整个实例会话:5000-step 主训练仅用 5 分 24.64 秒,其余时间主要用于选择机器、配置访问、安装依赖、观察日志、下载产物和解释结果。
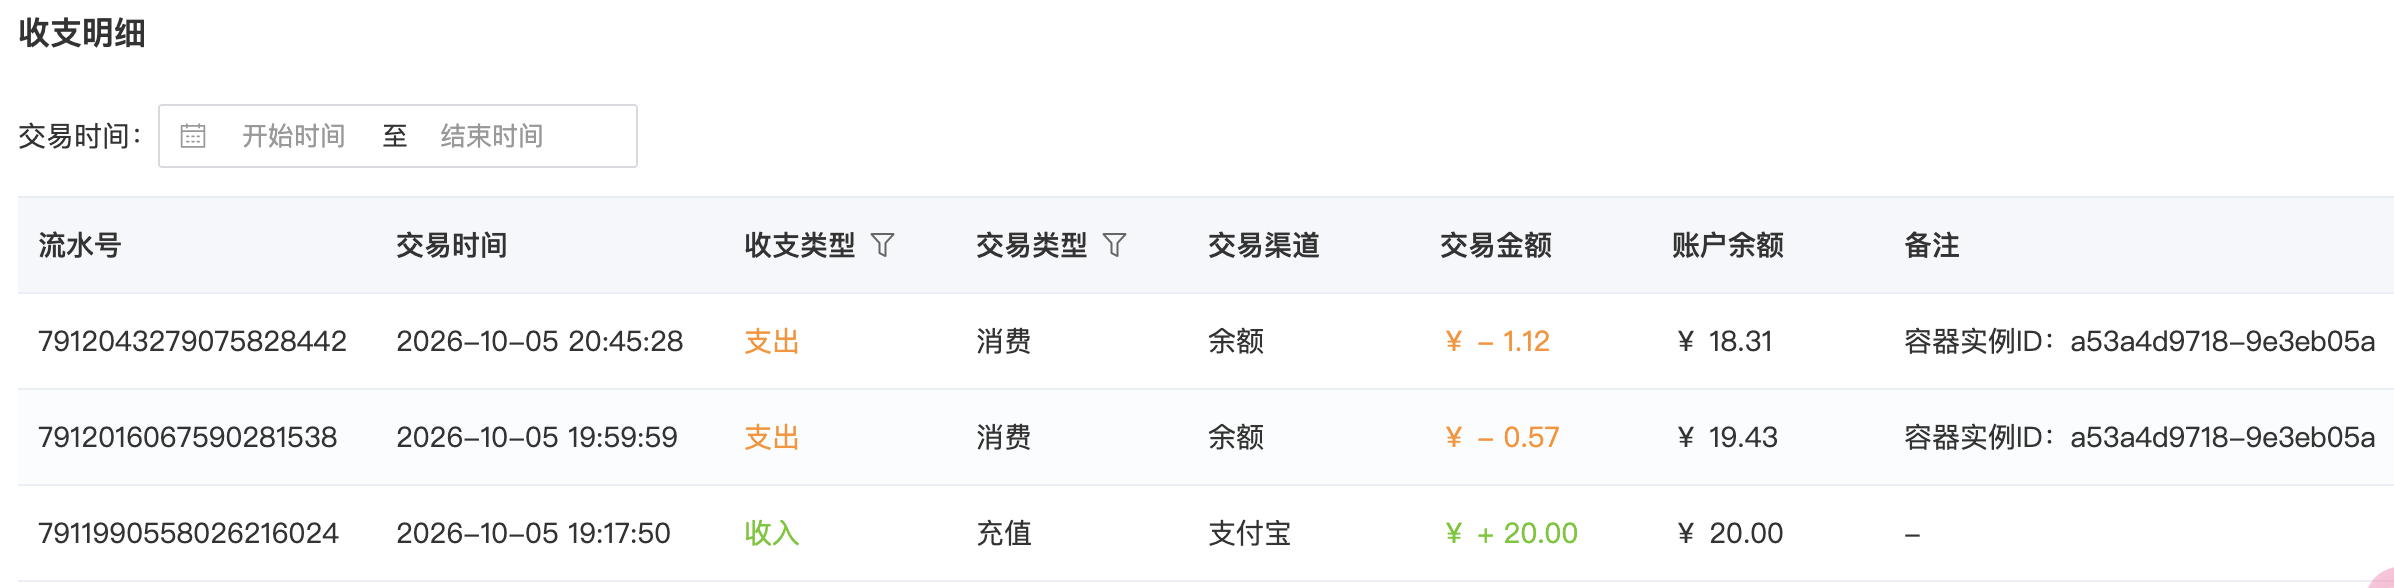
这个差异很重要:对小实验来说,最大的成本往往不是训练,而是人在 GPU 开机期间进行环境配置和排障。因此我给实例设置了定时关机,并在训练前把代码、配置和检查脚本准备好。
3. 数据与字符级 Tokenizer
Tiny Shakespeare 包含:
| 指标 | 数值 |
|---|---|
| 原始字符 | 1,115,394 |
| 词表大小 | 65 |
| 训练 token | 1,003,854 |
| 验证 token | 111,540 |
这里一个字符就是一个 token。65 个 token 包括大小写字母、换行、空格和标点。编码器只是两个字典:
1
2
stoi = {ch: i for i, ch in enumerate(chars)}
itos = {i: ch for i, ch in enumerate(chars)}
字符级 tokenizer 很容易理解,但效率不高。它适合第一课,却不适合后续中文通用模型;中文阶段会切换到 BPE,并重新训练模型权重。
数据采用前 90% 训练、后 10% 验证。我还为原始文本、训练集、验证集和 tokenizer 元数据分别记录了 SHA-256,以便以后确认输入数据是否发生变化。
4. 先做 Smoke Test
正式训练前,我先运行一个 0.40M 参数的小模型:2 层、hidden size 128、2 个 attention heads,只训练 20 step。
结果:
| 指标 | 数值 |
|---|---|
| 初始 validation loss | 4.1667 |
| step 20 validation loss | 3.0830 |
| 总耗时 | 3.79 秒 |
| checkpoint | 4.9MB |
生成结果仍近似乱码,但 smoke test 的目标不是文本质量,而是确认训练、保存、加载和生成链路都能工作。
这里还发现了第一个真实问题:训练成功后,sample.py 因缺少 tiktoken 导入失败。字符级采样实际会读取 meta.pkl,但上游脚本仍在文件顶部无条件导入 tiktoken。这说明“训练脚本能运行”不等于“项目依赖完整”。修复后,依赖被锁定到 requirements-shakespeare.txt。
5. 10.65M 参数模型怎样学习
正式配置为:
| 参数 | 数值 |
|---|---|
| Transformer 层数 | 6 |
| Attention heads | 6 |
| Hidden size | 384 |
| Context length | 256 |
| Batch size | 64 |
| Training steps | 5000 |
| 每 step token | 16,384 |
| 总 token exposure | 81,920,000 |
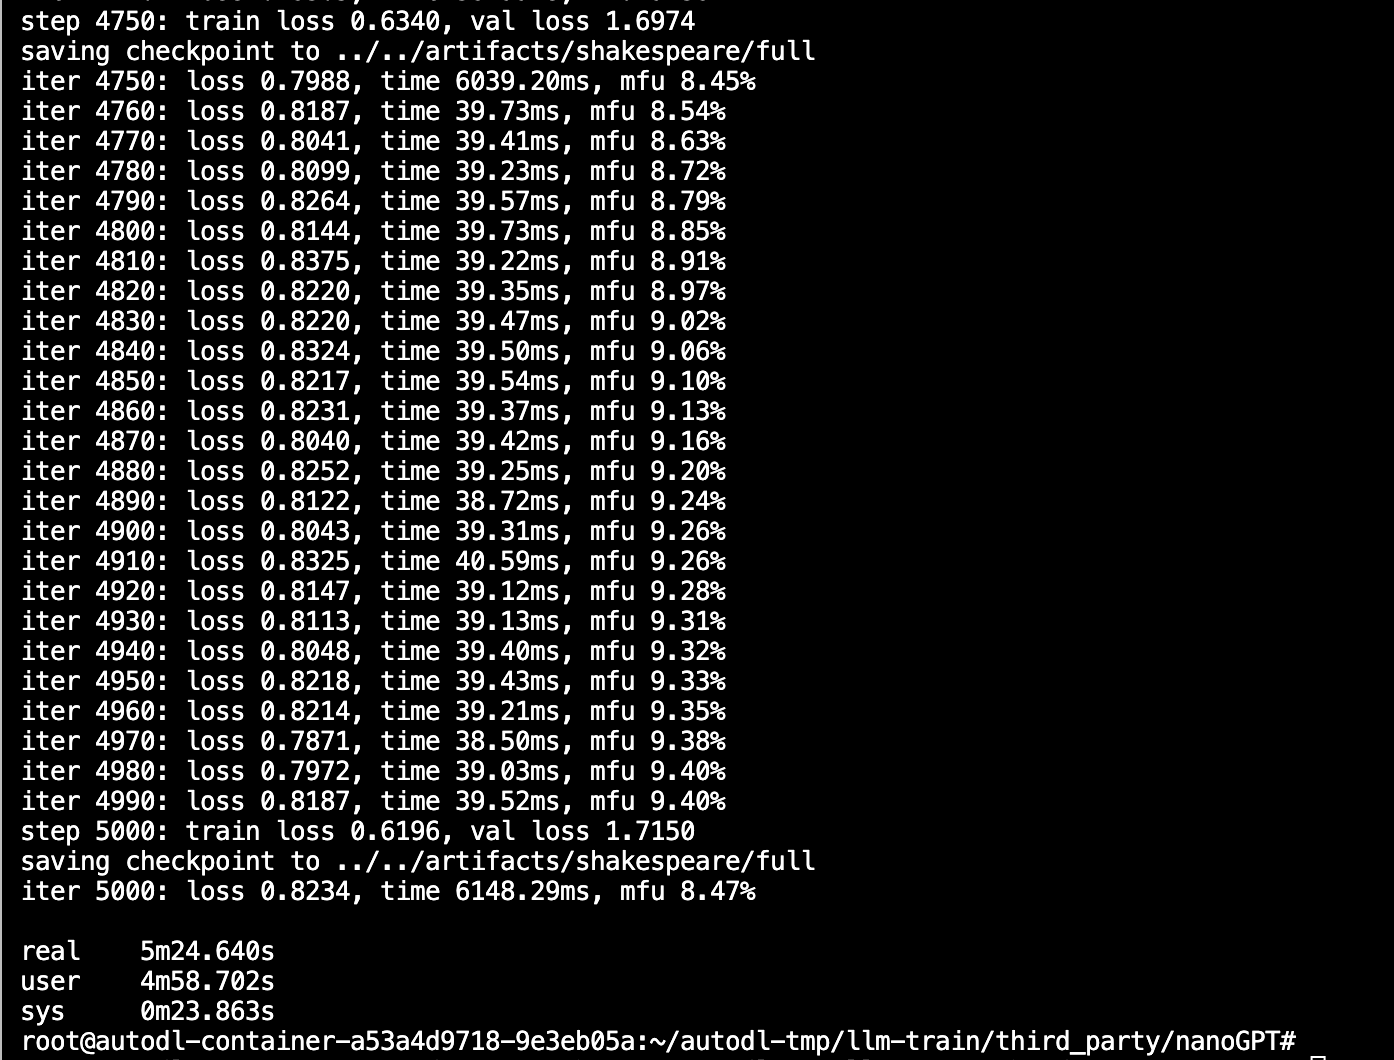
nanoGPT 报告约 10.65M 个非位置嵌入参数。稳定阶段单步约 39ms,约等于 42 万 token/s。显存只使用约 2GB,说明 24GB 3090 对这个模型明显过剩。
完整训练日志每 250 step 评测一次。下面摘录了能够说明趋势的关键节点:
| Step | Train loss | Validation loss |
|---|---|---|
| 0 | 4.2874 | 4.2823 |
| 500 | 1.5260 | 1.7253 |
| 1000 | 1.2739 | 1.5237 |
| 1750 | 1.1024 | 1.4693 |
| 2500 | 0.9587 | 1.4955 |
| 3500 | 0.7788 | 1.5881 |
| 5000 | 0.6196 | 1.7150 |
6. 为什么训练越久,模型反而越差
step 1750 后,train loss 继续下降,validation loss 却持续上升:
1
2
step 1750: train 1.1024 / val 1.4693
step 5000: train 0.6196 / val 1.7150
模型越来越擅长预测训练集,却越来越不擅长预测未参与训练的文本。这就是过拟合。
第一版配置还暴露了一个 checkpoint 策略问题:为了确保能恢复训练,我曾设置每次评测都覆盖保存 checkpoint,结果验证集更差的模型也覆盖了最佳模型。正确策略应当区分:
best checkpoint:validation loss 改善时保存,用于评测和部署。latest checkpoint:定期保存,用于故障恢复。
修正配置后,我保持原来的 5000-step 学习率轨迹,只重新运行到 step 1750。复现结果与第一次完全一致:
1
train loss 1.1024 / validation loss 1.4693
这证明数据、代码、随机种子、模型初始化和学习率轨迹都得到了固定。
7. 最佳模型与最终模型的生成对比
使用相同采样种子 1337、相同 temperature 和 top-k,两个模型都学会了人物名、冒号、换行和莎士比亚式语域。
step 1750 模型:
1
2
3
4
5
Clown:
So, who is her life?

Shepherd:
Fellow, Signior Claudio hast thou heard him to bed die.
step 5000 模型:
1
2
3
Clown:
So is it that we will make an incense to shrift the
garden to the sea for the traitor.
只看两段文本,很难稳定判断哪个更好。step 5000 的局部句式有时甚至更像训练语料,但它在整个验证集上的 next-token 概率更差。少量主观样本不能替代系统评测。
完整样本和训练日志作为实验记录单独保留;文章只展示其中具有代表性的片段。
8. Checkpoint 能恢复,但不等于逐 bit 延续
从 step 1750 checkpoint 恢复后,模型和 AdamW optimizer 均成功加载,并继续训练到 step 1760:
1
2
Resuming training from ../../artifacts/shakespeare/best
step 1750: train loss 1.1043, val loss 1.4709
恢复后的 validation loss 与原来的 1.4693 有轻微差异,因为这个 checkpoint 没有完整保存 Python、NumPy、CPU/CUDA RNG 状态和数据采样位置。
所以 checkpoint 有两个层次:
- 功能恢复:模型和 optimizer 能继续训练。
- 精确恢复:中断前后每个 batch、每个随机数和每个浮点结果都连续一致。
这次完成了第一层,没有实现第二层;恢复日志、环境版本和 checkpoint 哈希均已单独归档。
9. 这对 Agent 开发有什么帮助
训练一次小模型后,Agent 系统里几个常见现象更容易理解了:
- 模型的基本目标仍是 next-token prediction,Agent 的“规划”建立在这个生成机制之上。
- Tokenizer 决定上下文如何被切分,也直接影响上下文成本和可用长度。
- 一段回答看起来更流畅,不等于模型在整体分布上更可靠。
- checkpoint、随机种子、数据版本和评测集,和 Agent 的 prompt、tool schema、trace 版本一样需要管理。
- 只看几个 demo 很危险;固定评测集和可复现实验比“感觉更聪明”重要。
10. 成果与下一步
本轮产物压缩后为 226MB:
1
2
SHA-256:
12bc0648271b4b759a1ed8259b2da26127aa092a3d8e92738d88613a14c525b5
下一阶段会从字符级英文玩具数据走向中文小模型:
第一次实验没有得到强大的语言模型,但得到了更重要的东西:一条可以解释、测量、失败、恢复和复现的训练链路。