代码检索到底该怎么做:CodeGraph 与 CocoIndex 的一次实测
代码检索到底该怎么做:CodeGraph 与 CocoIndex 的一次实测
问题
Coding agent 的代码检索,应该依赖 grep/glob 这类关键字工具,还是依赖代码库图索引,向量索引?精确检索和向量检索组合后,能否在提高召回的同时控制误召回和上下文成本?
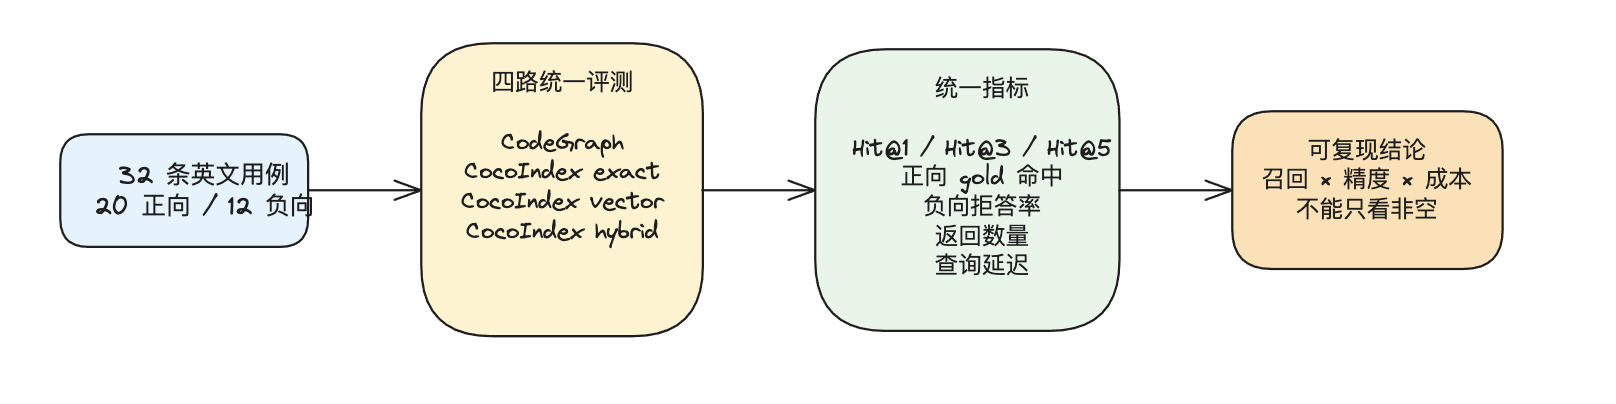
本文以个人coding agent xushun007/navi-agent repo 为输入,对 CodeGraph、CocoIndex exact、CocoIndex vector 和 CocoIndex hybrid 做统一英文测试。评价看正向问题是否命中 gold target,以及负向问题能否拒答。
在 32 条英文用例上,CocoIndex hybrid 取得最高的正向 Hit@5(13/20)和总通过率(22/32)。CocoIndex exact 的负向拒答最好(11/12),CodeGraph 的价值主要在调用、引用和路径关系,而不是单独承担最终候选排序。
因此,工程上更合理的组合是:grep/glob 或 exact 负责符号和路径,vector 负责自然语言,CodeGraph 负责结构验证,最后用 reranker 和拒答策略裁剪结果。简单 RRF 虽然增加召回,也可能重新带回误召回。
为什么要比较这几类方案
以 Claude Code 为例,常见的检索从工具调用开始。先用 glob 找文件,再用 grep 搜索符号或文本。打开命中的文件后,继续沿着引用追踪。官方文档给出的代码库探索流程也是先定位文件,再理解文件之间如何协作;需要更精确的定义和引用跳转时,再配合代码智能插件。Claude Code common workflows
Cursor 的技术文章则把语义搜索明确定位为 grep 的补充,并用离线评估和在线 A/B 测试观察它对 coding agent 的影响。Cursor:通过语义搜索改进智能体
两类方案解决的是不同问题:关键字检索直接但依赖查询措辞,语义检索表达灵活但相似不等于正确。CodeGraph 和 CocoIndex 的对比,正好可以把这两个问题拆开测量。
实验对象
输入仓库是 https://github.com/xushun007/navi-agent。我们实现了两套 HTTP 服务,并让它们接受相同的问题和返回有限的候选证据。
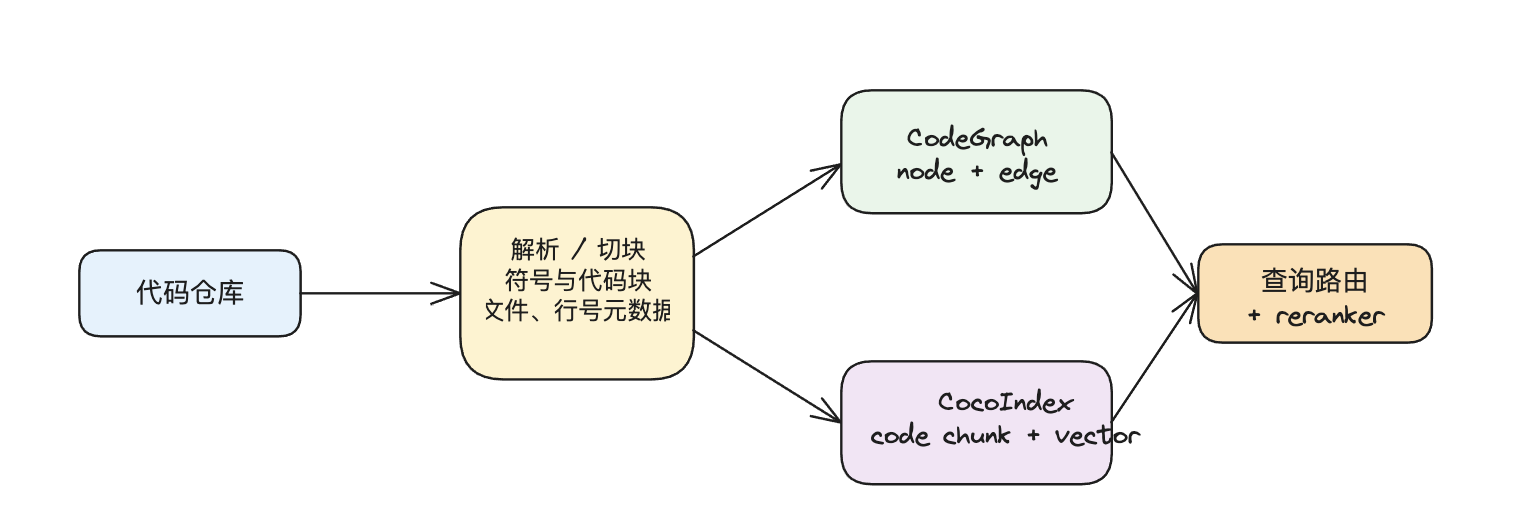
CodeGraph 服务把仓库转换成代码图。节点包含类、函数和模块,边表示定义、引用、导入或调用关系。查询先经过候选门控,再返回节点和关系。它适合回答“从 CLI 到运行时的路径是什么”“谁调用了这个服务”这类结构问题。
CocoIndex 服务采用另一种组织方式。代码通过 Tree-sitter 语法感知切块,保存文件、行号、代码块和向量,再分别提供 exact、vector 和 hybrid 三种查询模式。CocoIndex 官方代码索引示例也是“代码文件 → Tree-sitter 切块 → embedding → PostgreSQL/pgvector”,并支持增量更新。CocoIndex codebase indexing
需要强调:本实验里的 CocoIndex 默认索引保存的是代码块和向量,并不是 CodeGraph 那样的 node/edge 图。图关系仍由 CodeGraph 负责。
怎么测
验证集包含 32 条英文问题:20 条正向、12 条负向。正向问题覆盖标识符、文件定位、职责理解、工具与模型配置、调用和数据流;负向问题覆盖不存在的业务领域、通用词 near-miss 和仓库范围之外的能力。
例如,正向问题包括:
1
2
3
Where is AgentRuntime implemented?
How does the application call tools?
What is the path from the CLI to AgentRuntime?
负向问题包括:
1
2
3
Where is the payment processing system?
Where is the authentication middleware?
Where is the Kubernetes deployment controller?
所有通道都使用 Top-5 和相同的 gold target。正向问题只有在 Top-5 中出现目标文件或符号时才算命中;负向问题必须返回空结果。我们记录 Hit@1、Hit@3、Hit@5、负向拒答、平均返回数量和耗时。
这比只检查“接口是否返回 JSON”严格得多。payment processing system 如果召回了带有 system 单词的代码,应该算误召回,而不是成功。
结果
| 检索方式 | 总通过 | 正向 Hit@1/3/5 | 负向拒答 | 平均返回数(正/负) |
|---|---|---|---|---|
| CodeGraph | 17/32 | 6/10/11 | 6/12 | 8.00 / 3.75 |
| CocoIndex exact | 16/32 | 4/4/5 | 11/12 | 1.65 / 0.17 |
| CocoIndex vector | 18/32 | 7/9/9 | 9/12 | 4.55 / 0.25 |
| CocoIndex hybrid | 22/32 | 10/12/13 | 9/12 | 4.55 / 0.25 |
结果首先说明,四种方式没有一个能单独覆盖所有问题。
Exact 对标识符最可靠。exact_identifier 类别是 4/4,负向拒答是 11/12。但它不擅长从“哪个组件负责模型和工具执行”这样的自然语言中推断目标代码。
Vector 在工具、模型和配置类问题上达到 4/4,调用与数据流达到 3/4。它能理解“做什么”,但对 AgentRuntime、ReviewLoopService 这类精确符号不够稳定。
CodeGraph 的优势在结构。它可以继续沿着边查调用方、被调用方和路径。但平均返回 8 个候选,负向问题平均仍返回 3.75 个候选,说明图扩展必须有严格的入口和裁剪。
Hybrid 是本轮单服务结果最好的方式:总通过 22/32,正向 Hit@5 为 13/20。它主要用 exact 补上标识符,用 vector 补上配置和调用流。
误召回比漏召回更值得单独看
CodeGraph 的典型误召回是:查询 production payment gateway,结果落到了 CLI 文件;查询 3D game,结果落到了 eval 文件。通用词命中了图节点,但仓库并没有被询问的能力。
CocoIndex exact 只出现一条明显误召回:3D rendering engine 找到了 runtime engine 文件。它的边界更窄,所以拒答更稳定,但也因此牺牲了自然语言召回。
Vector 和 hybrid 共同出现了几类 near-miss:authentication middleware 找到文档索引,customer notification pipeline 找到 background task,production payment gateway 找到 gateway 测试文件。它们在语义上“有点像”,却不是问题的直接答案。
对 agent 来说,误召回会产生实际成本。一个错误候选可能触发额外的 read、继续的 grep,甚至让模型在错误上下文上作出判断。因此返回数量不能脱离相关性单独优化。
结论
这次实验不能证明 CocoIndex 全面优于 CodeGraph。它证明的是另一件更具体的事:
在这个仓库和这套英文问题上,CocoIndex hybrid 的正向召回最好;CocoIndex exact 的标识符定位和负向拒答最好;CodeGraph 的结构关系最有价值,但需要更强的候选门控。
因此,一个实用的 coding agent 检索层应当把几种能力分开:grep/glob 负责直接命中,exact 负责符号和路径,vector 负责自然语言语义,CodeGraph 负责关系和路径,最后再用 reranker 和拒答策略裁剪结果。
这里的“融合”也不能只是把所有结果用 RRF 拼起来。简单融合确实提高了召回,但可能重新带回通用词、测试文件和文档造成的误召回。下一步应该按查询意图选择通道,并在最终输出前判断“是否存在直接证据”。
验证集、评测脚本、运行命令和逐条结果均已放在 code-retrieval-lab 仓库中。
参考文献
- Anthropic, Claude Code — Common workflows。
- Cursor, 通过语义搜索改进智能体。
- CocoIndex, Index Your Codebase。
- Bui et al., Repository-level Code Search with Neural Retrieval Methods。
- Zhang et al., RepoCoder: Repository-Level Code Completion Through Iterative Retrieval and Generation。